그래스호퍼, LIST와 TREE 2편
INTRO
그래스호퍼는 앞선 포스트에서 다뤘다시피 3D 모델링을 하는 라이노를 보필하여 컴포넌트의 연결과정으로 매개변수를 패턴화하며 복잡하게 만들어냅니다. 이렇게 복잡하게 알고리즘이 생성될 시 그 안에는 수많은 도형들이 존재하며 이들을 분류하고 나열해야 하고자하는 디자인과 가깝게 도출할 수 있습니다. 이것을 그래스호퍼에선 list와 tree를 가지고 분류 작업을 할 수 있습니다. 이전에서 배운 List 개념에서 더 나아가 Tree에 대해 배워보도록 하겠습니다.
INTRO 그래스호퍼는 앞선 포스트에서 다뤘다시피 3D 모델링을 하는 라이노를 보필하여 컴포넌트의 연…
Data Tree
그래스호퍼의 Tree란 말 그대로 나무같은 역할을 한다고 생각하면 편합니다. 리스트에 있는 각각의 아이템들이 잎이나 열매라고 한다면 이들을 묶어주는 나뭇가지인 ‘BRANCH’가 존재합니다. 하나의 나무 기둥에서 시작하여 수많은 나뭇가지로 뻗어나가는 정보 분류 시스템이라고 할 수 있습니다.
여기서 언급한 ‘BRANCH’에 대해 알아보겠습니다. 브런치는 리스트 아이템을 묶어주는 그룹같은 역할을 하며 뜻 그대로 가지를 펼치며 한 브런치에 하나가 대응할수도 혹은 더 많이 3개 10개가 뻗어나갈 수도 있습니다. 이와같이 데이터 트리는 여러 브런치로 구성되어 있으며, 각각의 브런치가 데이터의 하위 그룹을 정의할 수 있습니다.
각각의 브런치는 브런치에 대한 식별번호인 고유한 경로(PATH)를 가지며, 이 경로는 브런치의 위치를 식별하는 데 사용됩니다.
아래 사진과도 같이 /0~/3으로 브런치를 구분한 것이며 리스트 데이터들은 경로에 따라 구분되어 후에 작용되는 컴포넌트에서도 걸맞게 사용됩니다.
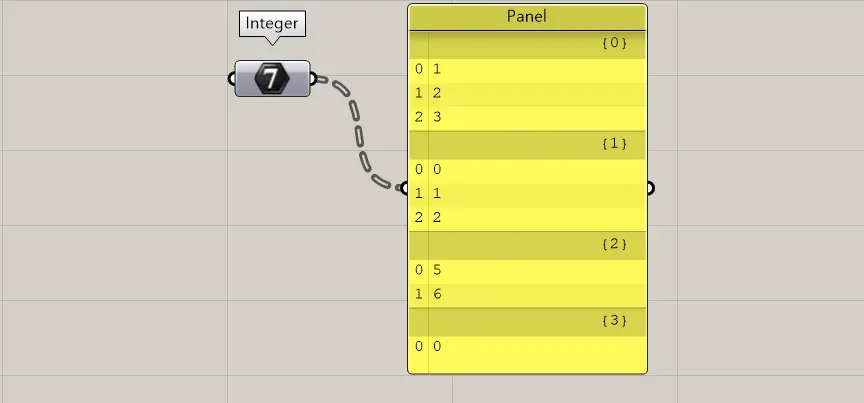
이전 기본 리스트 같은 경우는 패널로 임의 생성할 수 있었지만 브런치는 불가능합니다. 따라서 컴포넌트를 통해서 브런치가 생성되는 예제를 들어보겠습니다.
컴포넌트 SERIES를 가져오겠습니다. 이 컴포넌트는 집합의 공차수열이라고 볼 수 있습니다. 입력값 START는 수열의 시작값을 나타내고 뒤에 STEP은 공차이며 COUNT는 브런치당 배열될 수의 개수입니다. START 값에 리스트로 아이템을 여럿으로 나눠서 시작값을 주면 그 단일 리스트 안에 있던 아이템들이 브런치로 분류되어 수열이 진행되는 것을 확인할 수 있습니다.
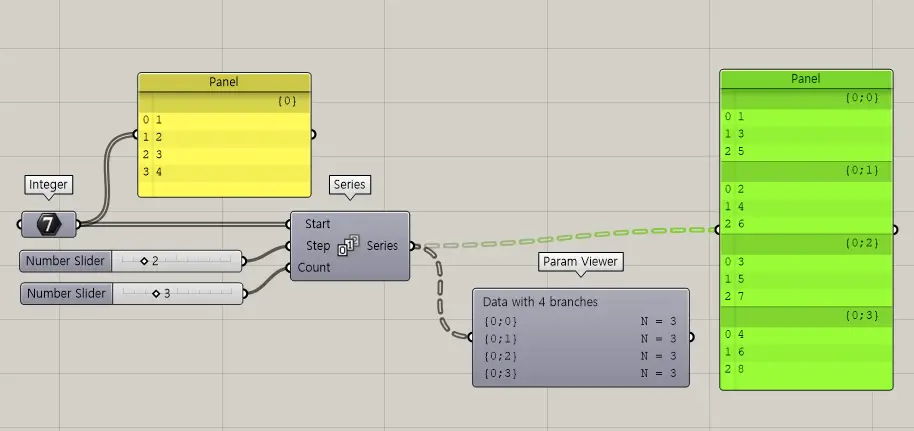
예제를 넘어서 이제 트리 컴포넌트들이 모여있는 상단 패널>SETS>TREE를 봐보겠습니다.
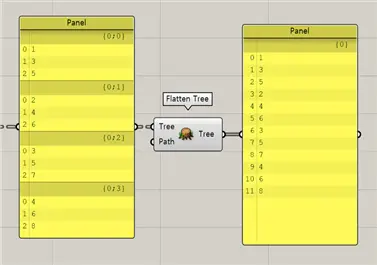
하단 사진과도 같이 나오는데 먼저 알아볼 컴포넌트는 ‘Flatten Tree’입니다. 이 컴포넌트는 브런치로 나눠진 트리들을 모두 펴줘서 하나의 브런치로 되돌리는 컴포넌트입니다.
이 컴포넌트는 입출력값 우클릭 메뉴 중에서도 flatten으로 존재하여 컴포넌트로 연결짓는 것보다 더욱 편리하게 리스트를 누르고 작업을 진행할 수 있습니다.
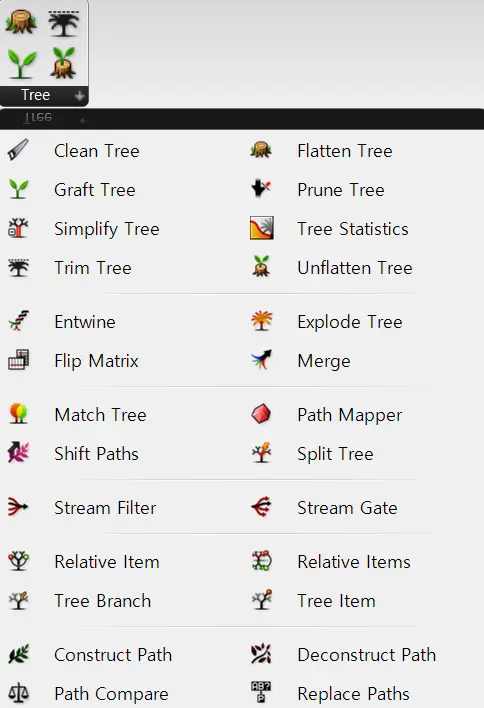
Flatten 말고도 입출력 변수값 우클릭 메뉴에는 Reverse, Graft, Simplify, Expression이 있습니다. Reverse는 리스트 순서 반전, Graft는 Flatten과 반대로 모든 아이템을 각각 나눠 하나당 하나씩 브런치를 만들어냅니다. 이는 컴포넌트로 Unflatten과 동일합니다. Simplify는 경로(Path)에서 불필요한 0을 제거하는 역할을 하며 0 뿐만 아니라 다른 중복 요소를 제거해 트리 구조의 상대적 구조는 유지하면서, 불필요하게 복잡한 경로는 최소화할 수 있습니다. 이는 여러 컴포넌트를 거치면서 트리 구조가 점점 복잡해지는 상황을 정리하는 데 유용합니다. ( Before, {0;0;1;0} -> After, {1} ) 마지막으로 Expression은 함수 연산을 통해서 리스트에 수를 편집하는 역할을 합니다.
트리 컴포넌트들을 보면 리스트 항목의 자료들을 정리하는 역할을 한다는 것을 항시 인지하면서 생성을 하면 보다 수월하게 진행할 수 있습니다. ‘Tree Branch’ 컴포넌트는 말 그대로 데이터 트리 안에 있는 여러 가지 (branch) 중에 원하는 가지를 선택하여 출력값으로 보여주는 컴포넌트입니다.
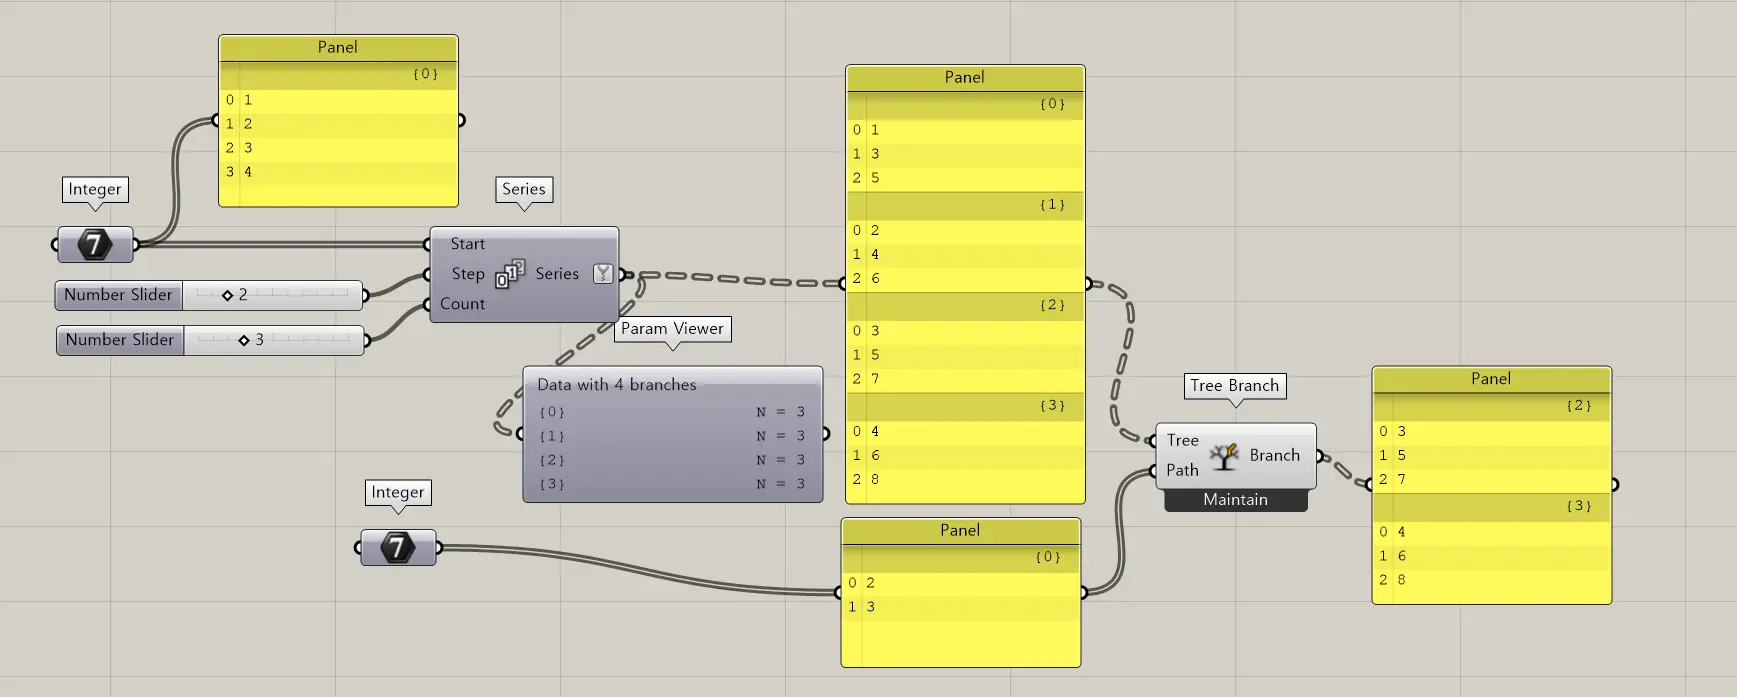
위 사진과도 같이 이전에 수열로 브런치가 적절히 생성된 트리를 Tree Branch의 입력값 Tree와 연결해서 전체 리스트를 조성하고 입력값 Path 에 경로의 번호를 뜻하는 아이템을 연결하면 출력값으로 전체 트리의 해당 경로만 선택해올 수 있습니다. 이것은 저번 시간에 배웠던 List Item과 유사하며 이는 자료 정리에 중요한 역할을 해낸다는 것을 알 수 있습니다.
데이터 매칭
리스트와 트리를 구분 짓는 방법을 지금까지 배워왔으니 데이터 매칭에 대해서 알아보겠습니다. 그래스호퍼에서 하나에 트리 안에 있는 자료를 구분 짓는 방법에 대해서는 이해하였지만 앞으로 복잡화하며 컴포넌트를 이어나갈 때 어떤 자료가 어떤 자료랑 매칭이 되어야 되는지 인지해야 합니다.
그러기에 데이터 매칭을 진행할 때에 어느 정도 기본 규칙을 알고 있어야 합니다.
[규칙]
데이터 트리는 반드시 한 개 이상의 브런치를 지닌다.
브런치는 반드시 한 개 이상의 아이템을 지닌다.
브런치는 브런치끼리 대응하며 이는 내부에 아이템과 대응한다는 뜻이다.
이러한 규칙을 기반으로 리스트 데이터 메칭에서 사용되는 Longest list, Shortest list, Cross reference 컴포넌트에 대해 알아보겠습니다.
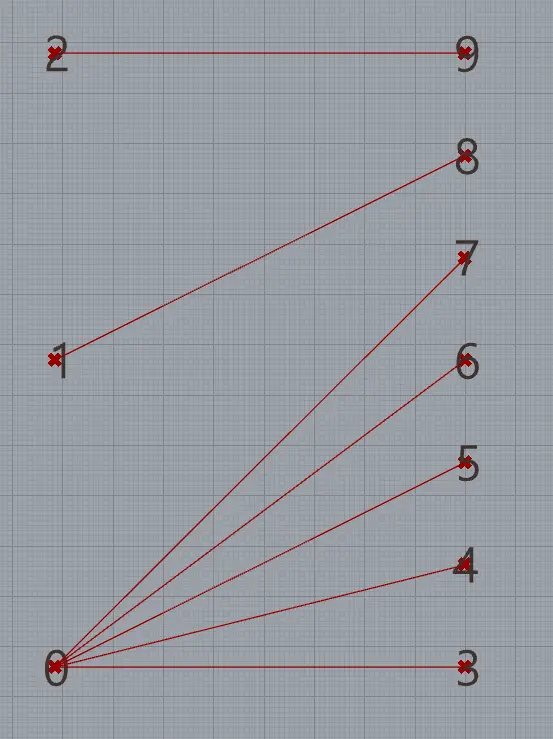
우선 Longest list입니다. 데이터 매칭이 이루어질 때 각각의 리스트가 지니고 있는 아이템과 브런치의 개수가 다르기 때문에 무조건적인 일대일 대응을 기대하긴 힘듭니다. 이럴 때 연산을 하는 방식으로서 Longest list가 있습니다. 이 방식은 입력 변수에 서로 다른 항목 수의 리스트 자료들이 입력되면 항목 수가 많은 리스트 자료에 맞추어 다른 리스트 자료를 가공하여 일대일 대응을 시켜줍니다.
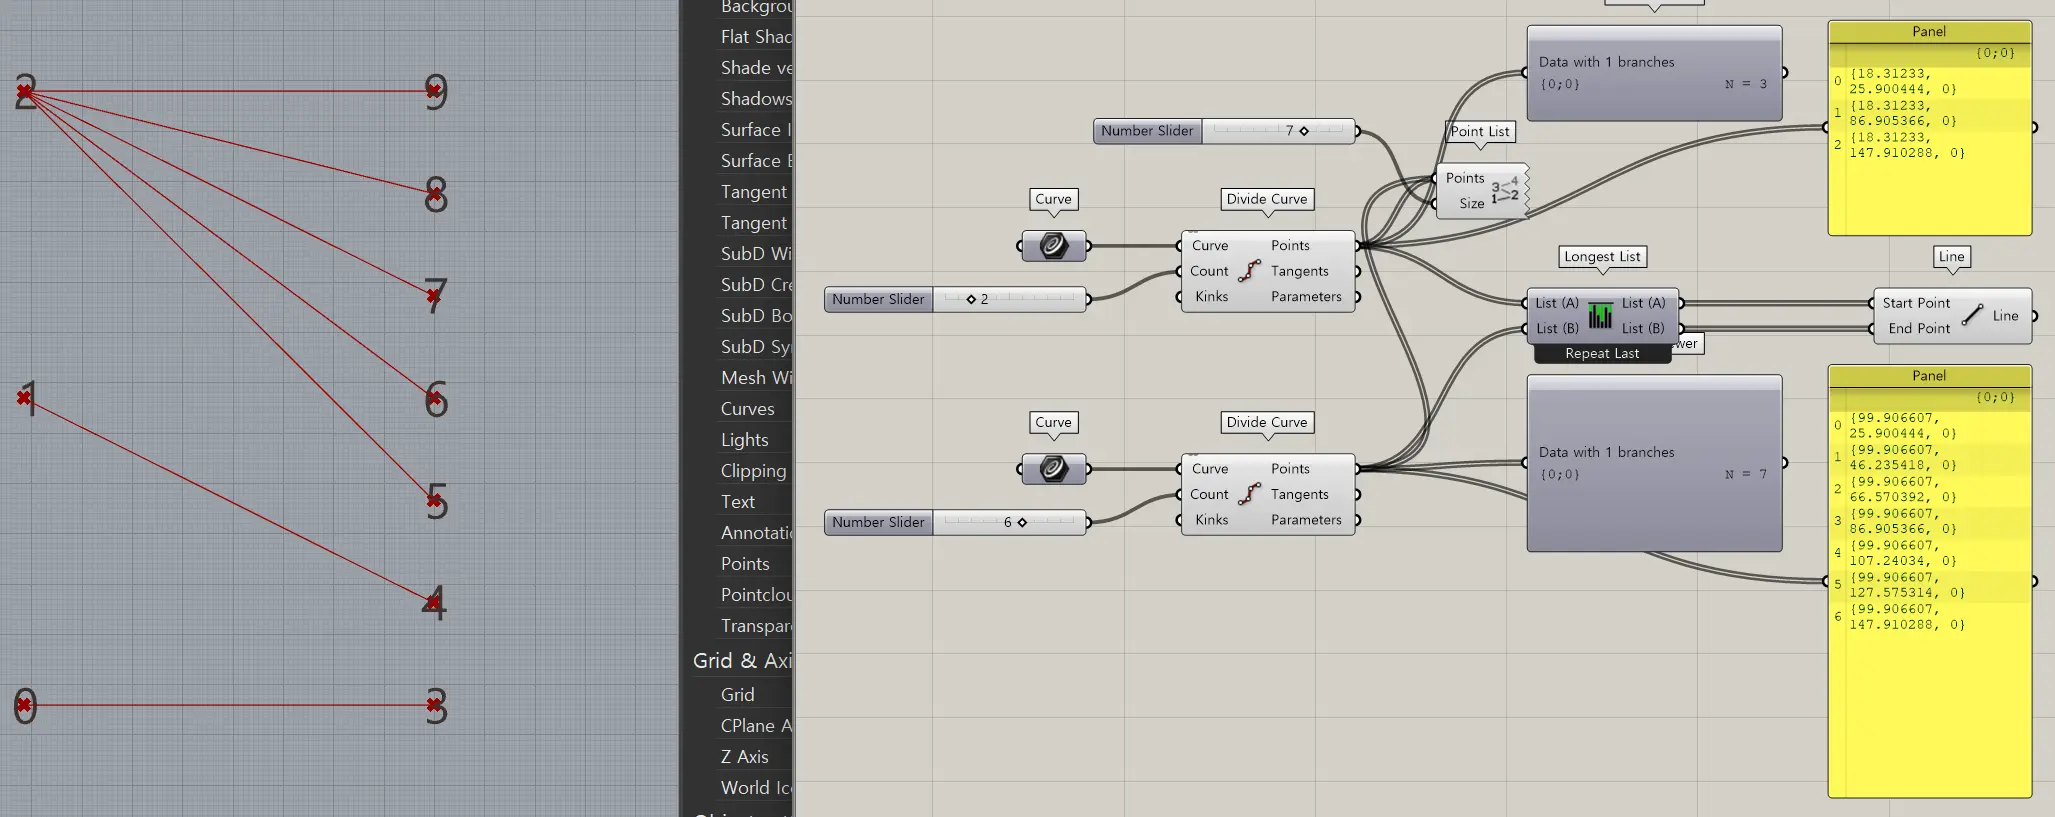
위 사진을 보면 가장 하단에 있는 아이템부터 각각 하나씩 연결이 되다가 마지막 하나와 나머지 여럿이 남게되니 일대다로 선택되는 것을 확인할 수 있습니다. 결국엔 어느 아이템도 빠지지 않고 다른 아이템과 대응하게 됩니다.
여기서 Longest List 컴포넌트의 중앙부를 우클릭하여 메뉴를 열면 Repeat First, Repeat Last, Interpolate, Wrap, Flip이 나옵니다. Repeat First는 첫 항목을 반복시키고, Repeat last는 마지막 항목을 반복시키며, Interpolate는 모든 항목을 골고루 반복시키고, Wrap은 리스트 전체를 순서대로 반복시키며, Flip은 리스트 전체를 역순으로 반복시킵니다. 기본값은 Repeat Last이며 모두 대응시키는 방식의 종류인 것이지 Longest list는 어떻게든 남는 거 없지 순환하여 모두 대응시킨다는 것은 변함이 없습니다.
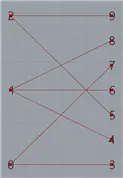
다음으로 Shortest list 컴포넌트입니다. 이것은 이전 Longest list와 반대로 무조건적인 대응이 아닌 일대일 대응만이 허락되는 컴포넌트입니다. 따라서 대응되지 못하는 아이템들이 존재하게 됩니다.
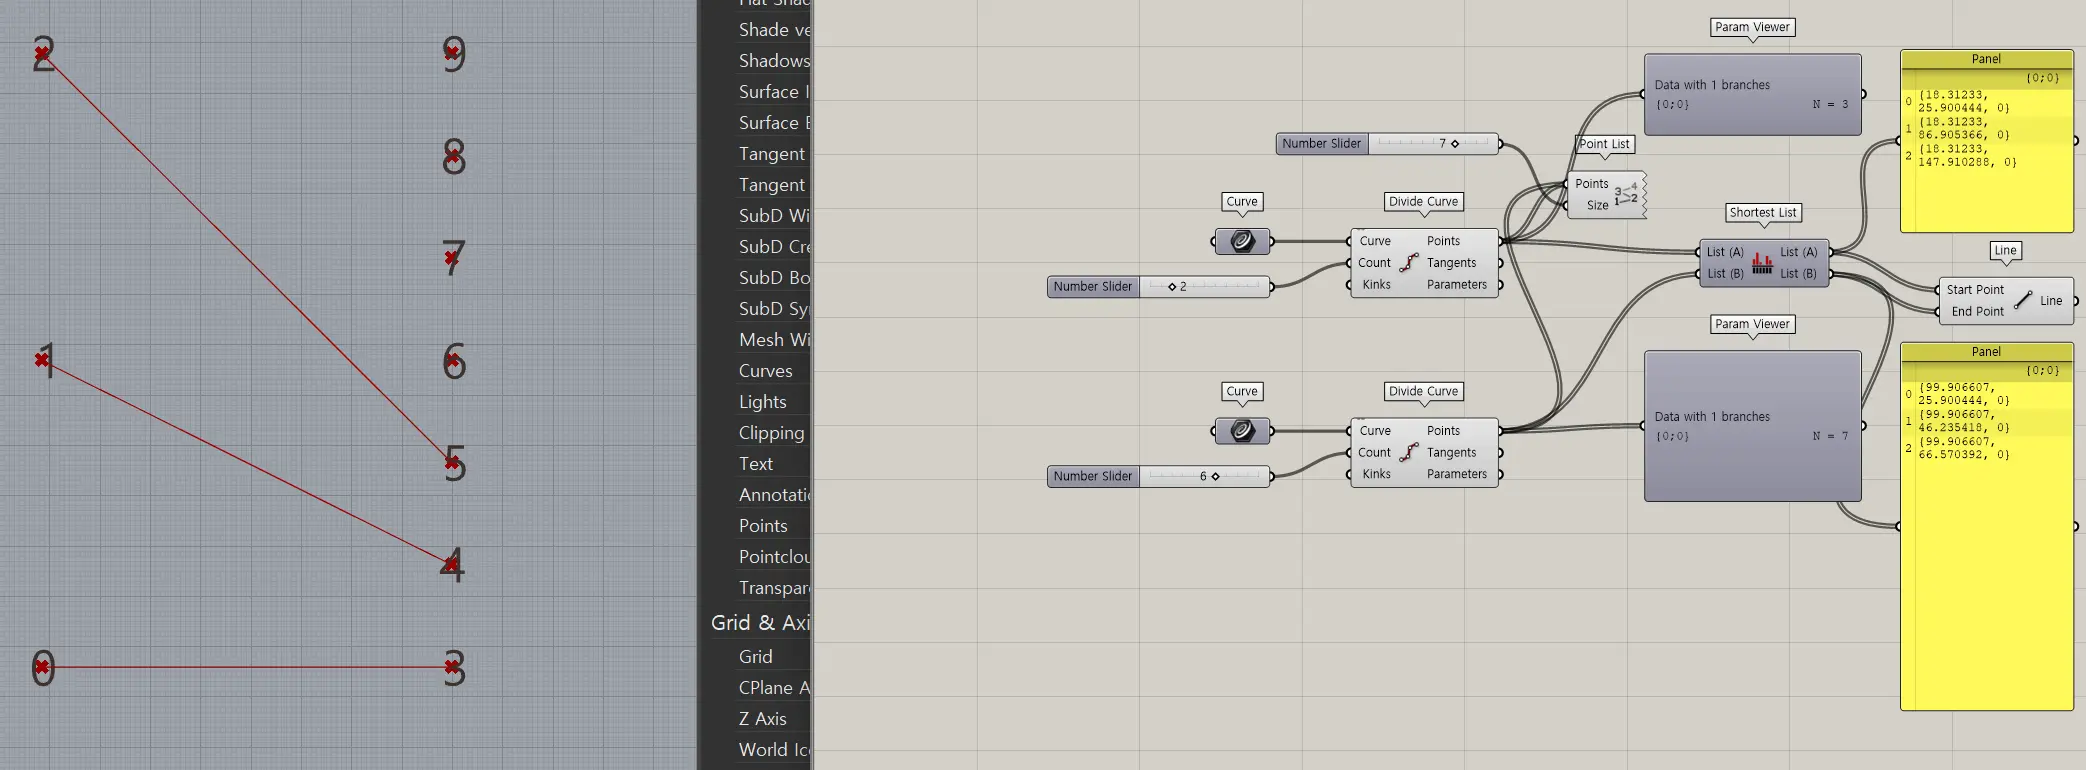
Shortest list도 마찬가지로 패턴을 변경할 수 있는 Trim Start, Trim End, Interpolate가 존재하며 기호에 따라 변경할 수 있습니다.
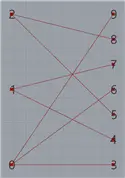
다음으론 Cross Reference 컴포넌트입니다. 위에 Longest 와 Shortest 는 일대일 대응의 변형 방식이라고 한다면 이 컴포넌트는 다대다 대응의 방식입니다. 모든 각각의 아이템들이 상대 리스트 아이템과 대응을 이루기에 최대의 복잡한 구조를 이뤄낼 수 있습니다.
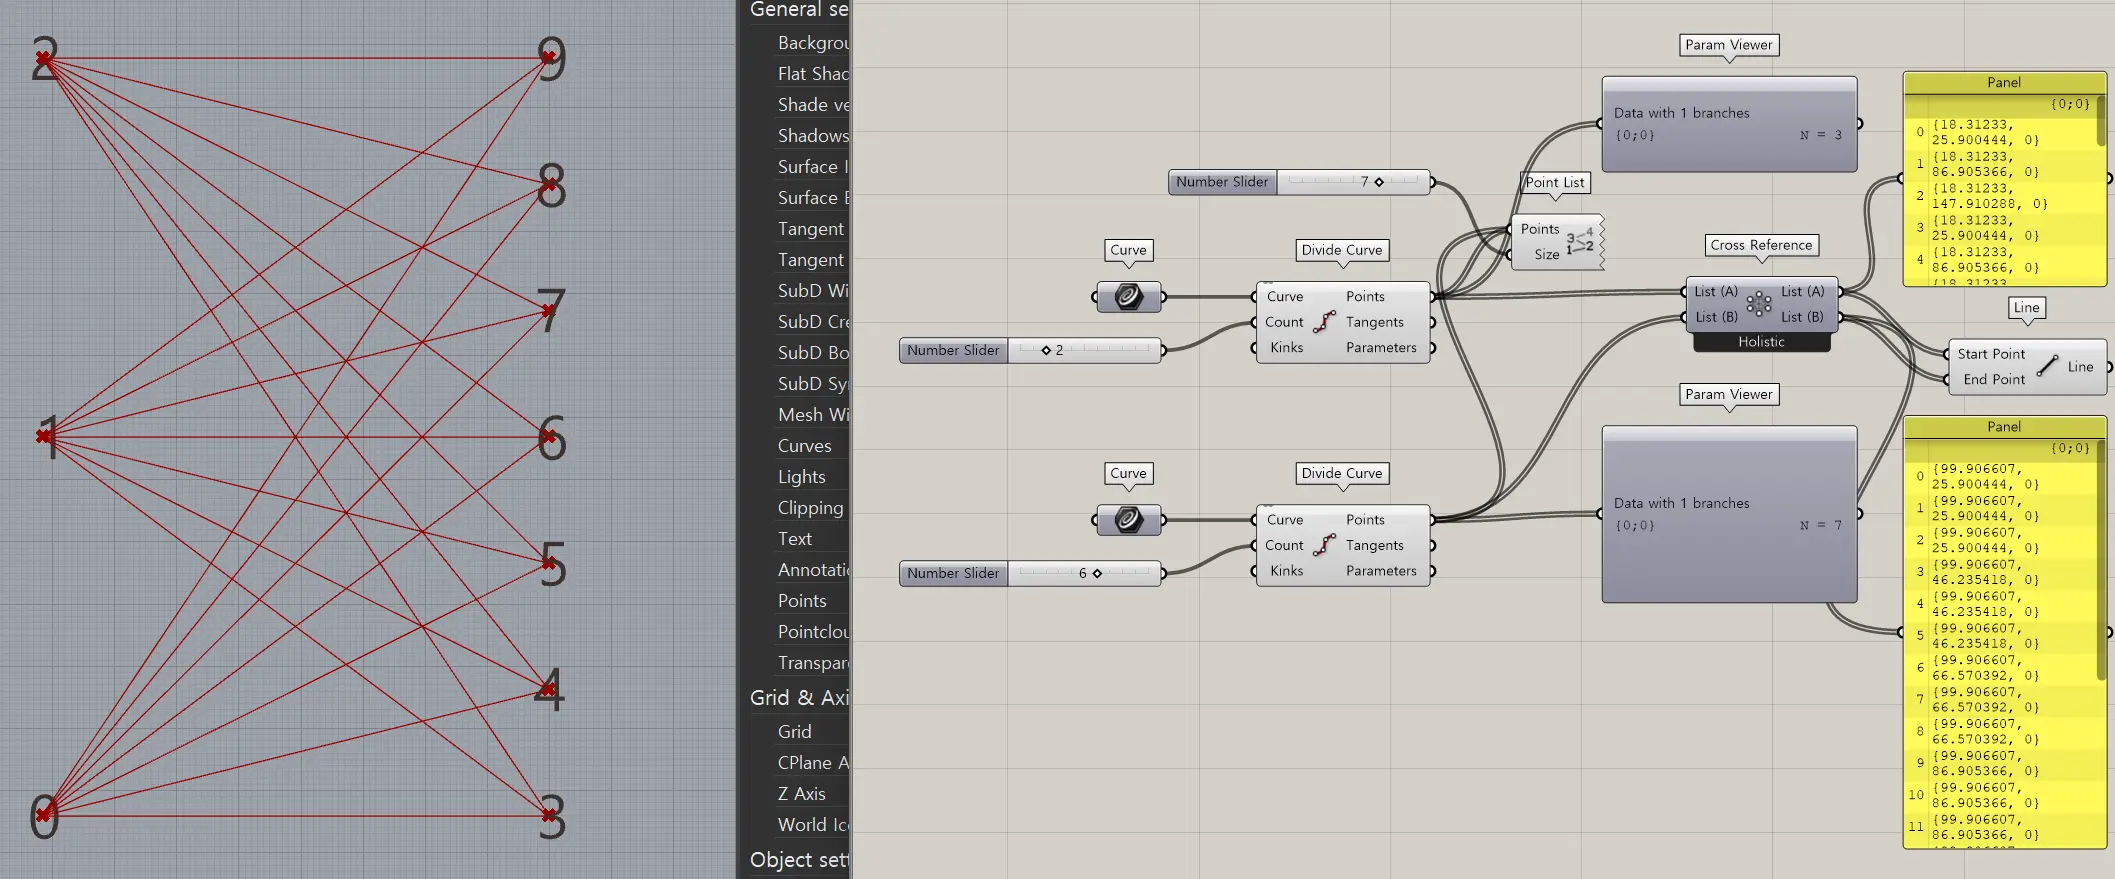
리스트 간의 모든 조합이 서로 조합됩니다.
리스트 A: 길이 m
리스트 B: 길이 n
결과 리스트: m X n 조합
복잡한 디자인 패턴을 생성하거나 격자 기반 작업에서 필수적으로 쓰이게 됩니다.
OUTRO
이렇게 데이터 트리 내에 아이템을 다루고 이 아이템을 브런치로 묶어서 다른 컴포넌트 리스트와 연결 짓는 것을 2탄까지 하여 알아봤습니다. 라이노같은 3D로 보여주는 매커니즘이 아니다보니 눈에 보이는 Loft 자체도 데이터 트리의 정리가 다른 상태라면 오작동을 할 경우가 많습니다. 따라서 매개변수를 제대로 익히고 활용하려면 이번 시리즈로 설명드렸던 데이터 정리는 필수입니다. 이번 시리즈를 통해서 데이터 정리에 대한 중요도와 그에 따른 이해가 됐으면 하는 바람이며 활용하여 더욱 다양한 디자인을 만들 수 있으면 좋겠습니다. 감사합니다 !