실전 AI설계 ④ 〈화면공유 + Voice 챗을 통한 실시간 크리틱〉
- 발행
- 2026.01.05
INTRO : 프로젝트 디벨롭, 이제는 AI 사수와 함께
설계의 핵심은 완성된 결과보다 그 과정에서의 판단과 조율에 있습니다. AI 역시 그 과정에 꾸준히 활용되어 왔지만, 대부분은 이미지나 텍스트를 주고받는 정적인 피드백 구조에 머물렀습니다.
이제 AI는 단순한 평가자가 아니라, 작업 과정 속에서 함께 판단하고 대화할 수 있는 동료로 확장되고 있습니다. 특히 화면공유와 음성대화 기능은 설계자가 작업 중인 화면을 직접 보여주며 즉각적인 피드백을 받을 수 있는 환경을 가능하게 했습니다.
이 글은 아직 완전한 시각–언어–행동(VLA) 모델이 아니더라도, 현재의 LLM + 멀티모달 구조를 최대한 활용하여 AI를 프로젝트를 함께 디벨롭하는 파트너로 쓰는 방법을 제시합니다.
Part 1. 실시간 화면공유와 보이스의 처리방식
이미지 + 텍스트와의 차이
사실 AI가 화면공유를 통해 받아들이는 데이터는 영상이 아닙니다. 실제로는 초당 여러 장의 **정지 프레임(캡처 이미지)**이 빠르게 교체되는 형태입니다. AI는 그중 마지막 프레임, 즉 현재 보이는 한 장면을 분석합니다.
따라서 기술적으로는 기존의 이미지 입력과 다르지 않지만, 그 위에 **실시간 보이스**가 동시에 결합되면서 대화의 구조가 완전히 달라집니다.
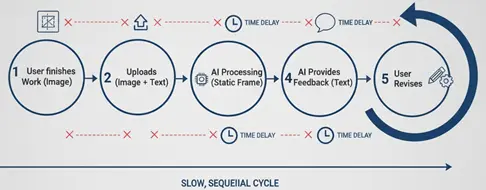
기존의 이미지 + 텍스트 방식은 ‘결과물 → 설명 → 피드백’의 순서로 이루어졌습니다. AI는 완성된 이미지를 보고 판단한 뒤, 사용자는 그 결과를 다시 반영했습니다. 즉, 모든 대화가 사후적 구조에 머물러 있었습니다.
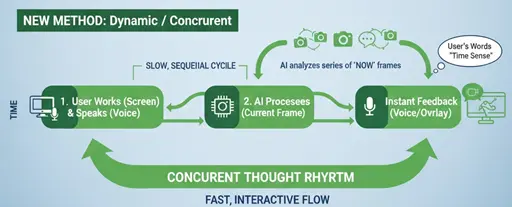
반면 실시간 화면공유와 음성 입력에서는 ‘작업 → 말하기 → 즉시 피드백’이 거의 동시에 일어납니다. AI가 이해하는 것은 여전히 현재 프레임뿐이지만, 음성이 그 순간의 의미를 고정시키고 다음 프레임으로 이어주는 역할을 합니다. 그래서 기술은 정적이지만, 대화는 동적입니다.
Tip: Image 생성 기능을 통해 특정 영역의 알트를 실시간으로 생성 가능
결국 이 구조의 본질은 시간의 흐름을 AI가 해석하는 것이 아니라, 사용자의 말이 시간의 감각을 만들어낸다는 데 있습니다. 이는 현실에서 우리가 실제로 크리틱을 받고 발표를 하는 상호작용과 동일합니다.
이미지 + 텍스트가 결과를 평가하는 과정이었다면, 화면공유 + 음성대화는 진행 중인 과정 자체를 함께 사고하는 행위로 바뀝니다. AI는 여전히 ‘현재’만 인식하지만, 그 현재가 사용자의 언어를 따라 끊임없이 갱신되면서 사고의 리듬이 인간과 AI 사이에서 동시적으로 흐르게 됩니다.
Part 2. VLA처럼 활용하기 위한 입력 전략
AI의 시선을 만들어주는 방법
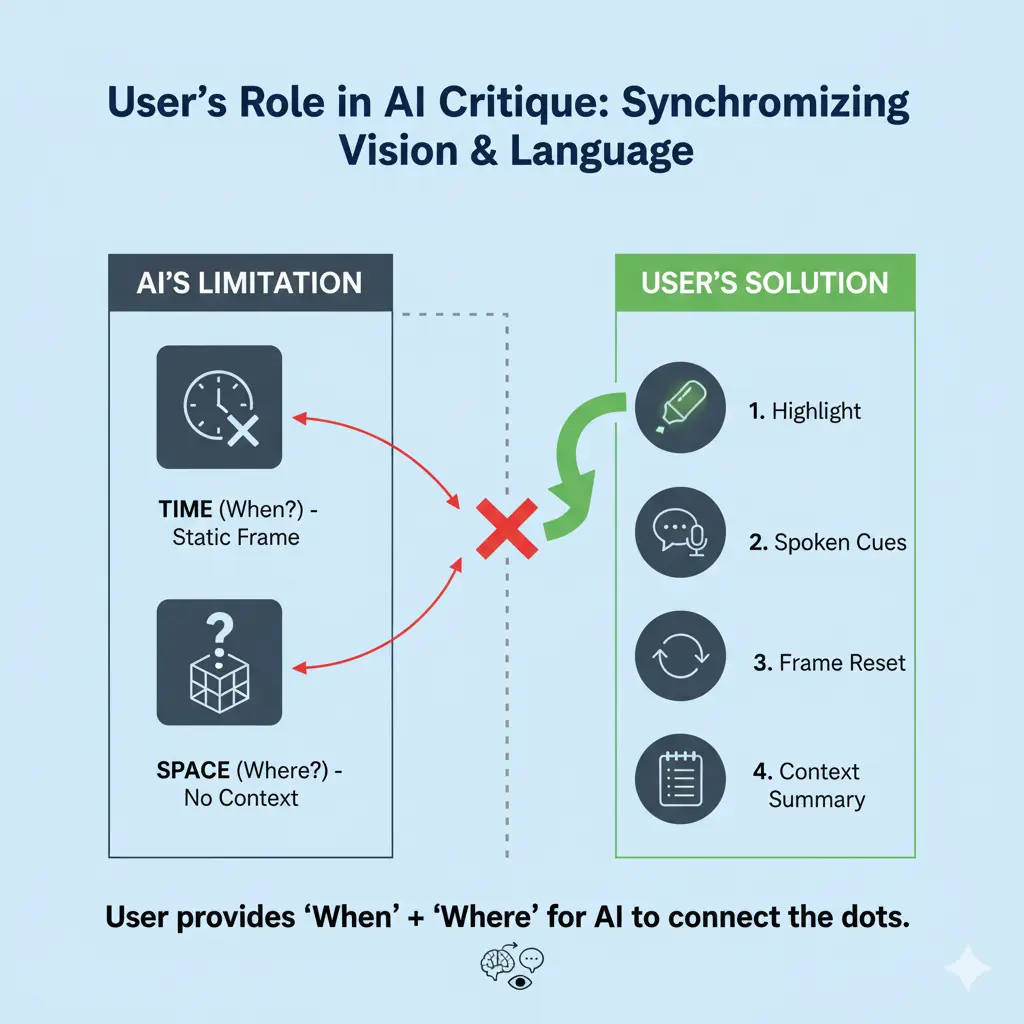
AI가 공유된 화면을 처리할 때, 그 이미지는 실제 ‘움직이는 장면’이 아니라 매 순간 새로 입력되는 정지 프레임입니다. 따라서 AI는 “지금 이 장면이 이전 장면의 연속이다”를 스스로 인식하지 못합니다.
또한, 음성 입력이 더해지더라도, 그 말이 어느 시점의 화면을 가리키는지 명확히 연결되지 않으면 AI는 언어와 화면 사이의 간극을 경험하게 됩니다.
따라서 지금 우리가 해야 할 일은 AI가 스스로 행동을 인식하지 못하더라도, 사용자가 ‘시점’을 대신 달아주는 것입니다. 즉, “이 프레임에서 말하고 있다”는 기준을 만들어줘야 AI가 언어와 화면을 정확히 연결할 수 있습니다. 이를 위해 사용자가 쓸 수 있는 방법이 바로 하이라이트, 지시 언어, 프레임 리셋, 시점 요약입니다. 이 전략들은 기술적으로는 단순하지만,
결국 AI의 시점을 만들어주는 행위입니다. AI가 공간을 이해하지 못하고, 시간의 흐름도 인식하지 못하므로 사용자가 직접 그 두 요소 — ‘어디(공간)’와 ‘언제(시점)’ — 를 부여하는 것입니다. 이렇게 하면 AI는 비록 완전한 인식은 아니더라도, 시각과 언어의 표현 동기화를 가능케 합니다.
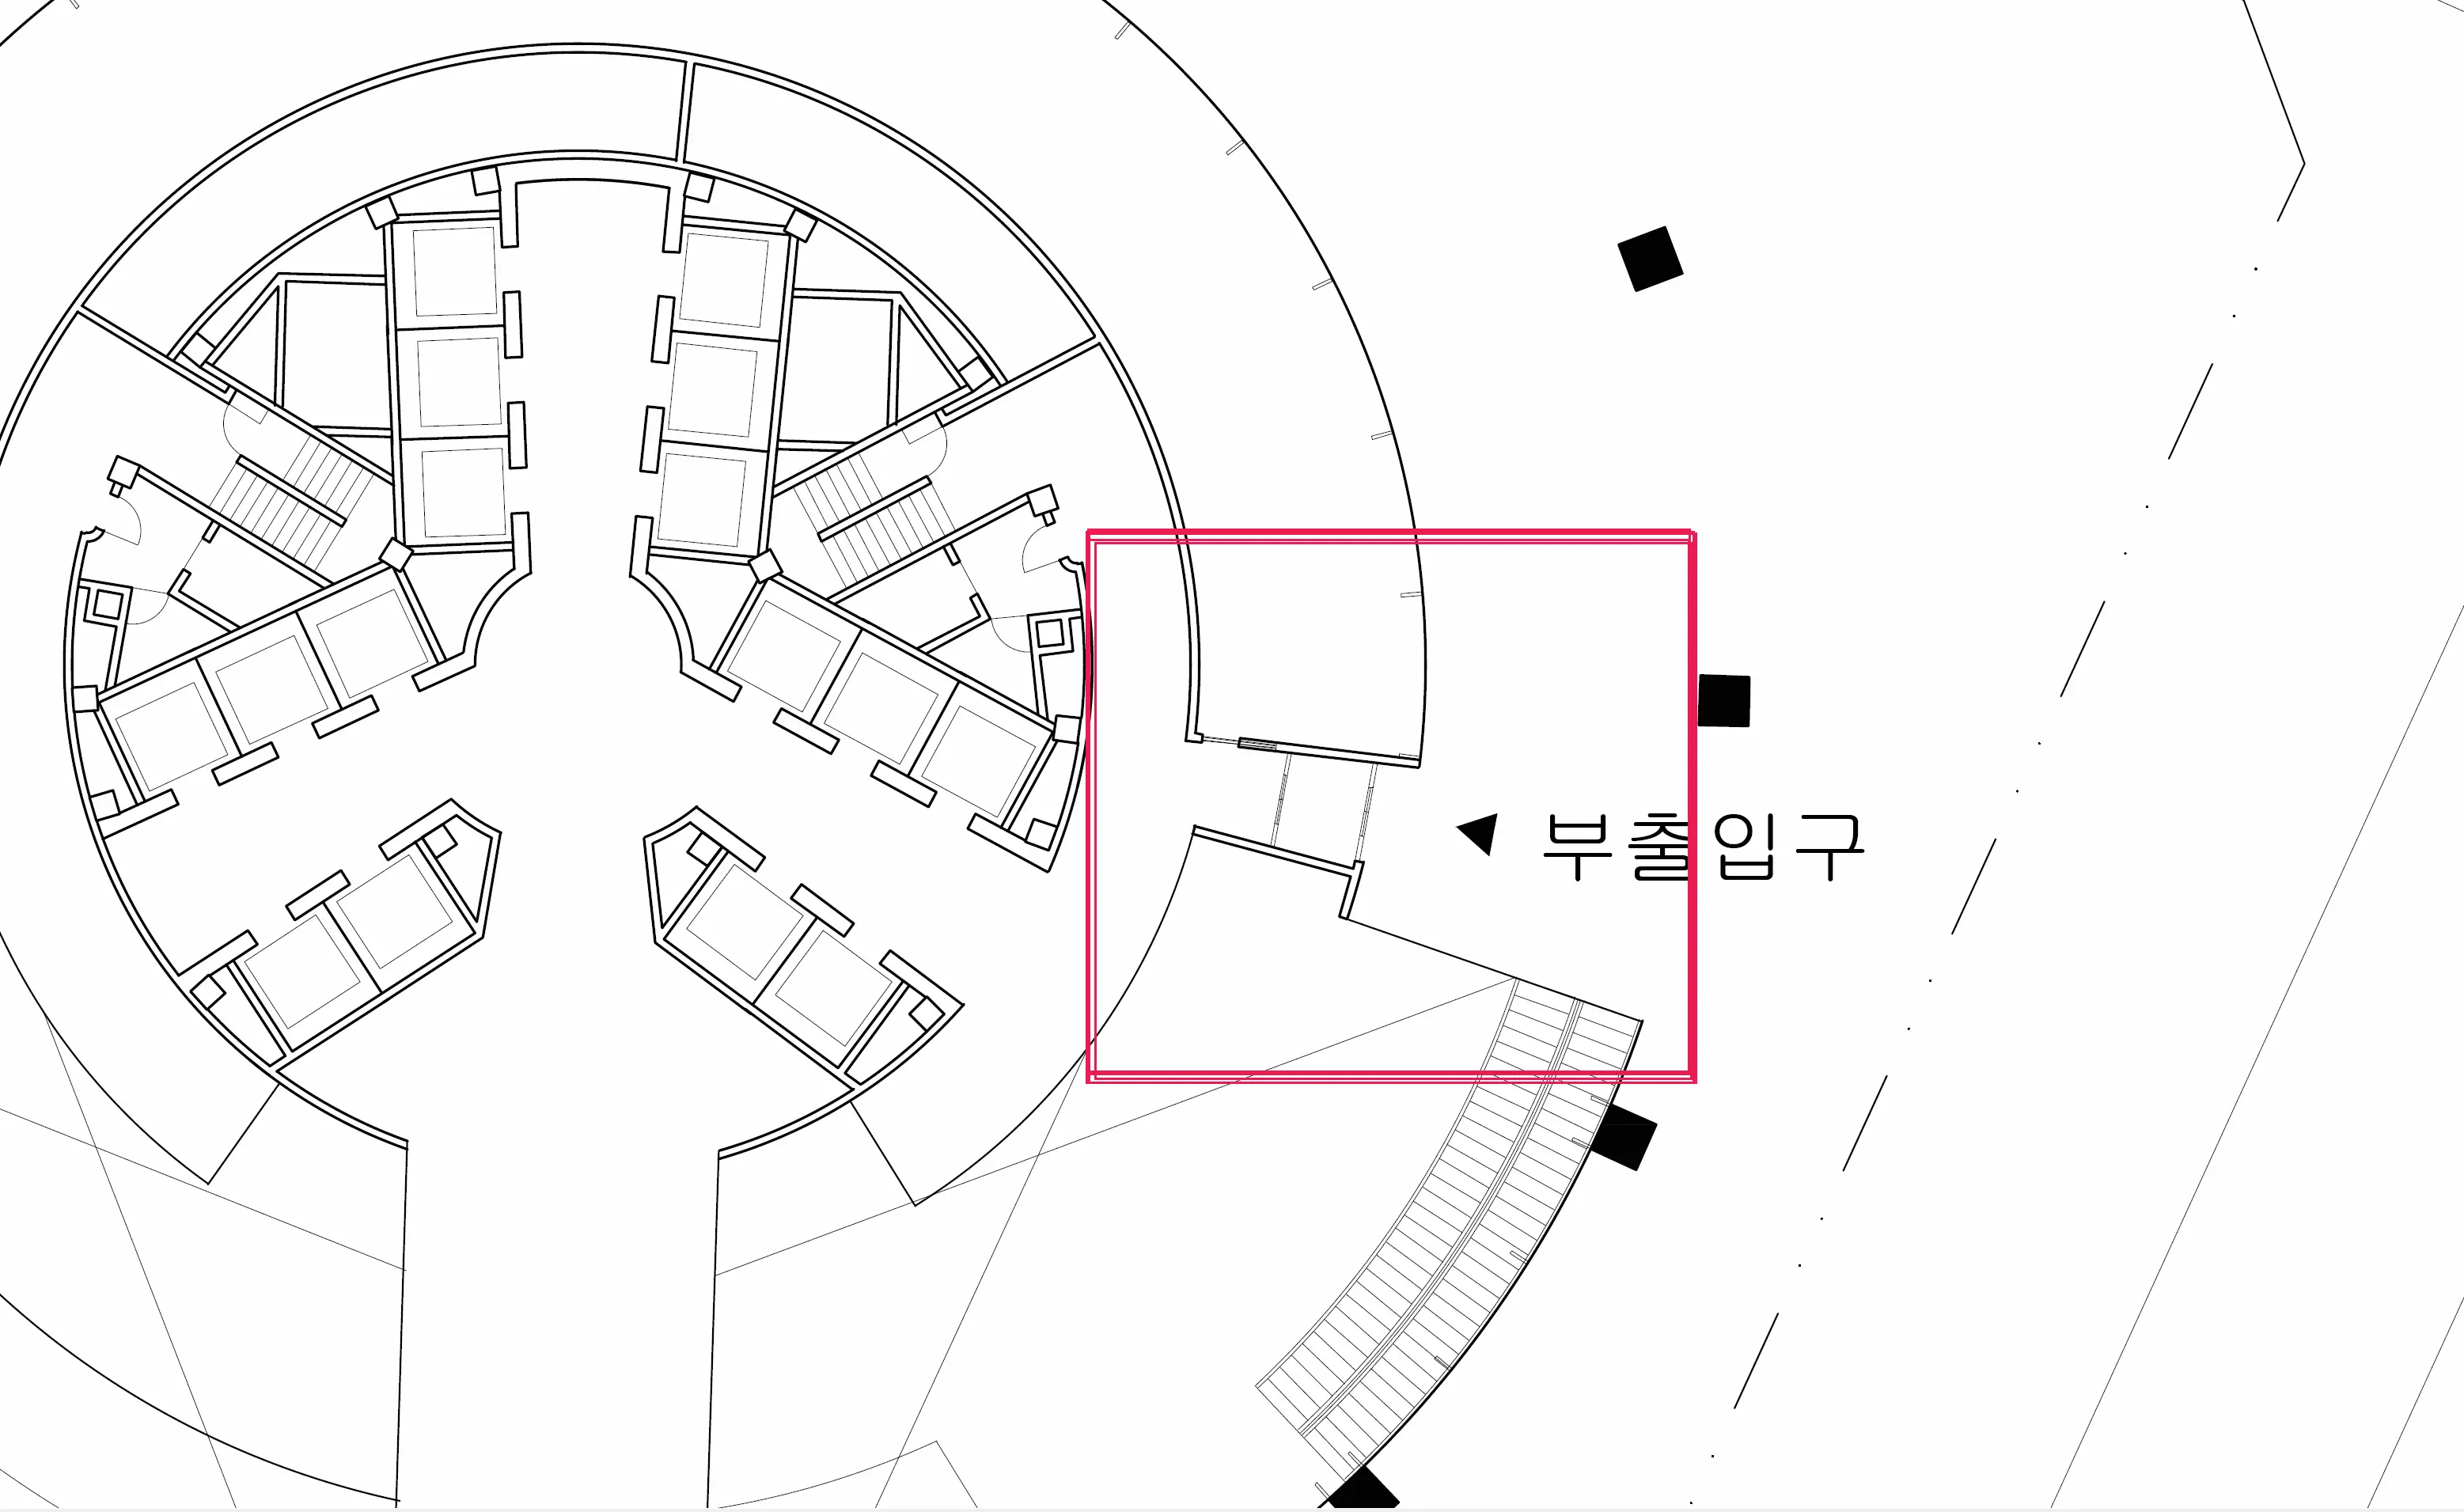
① 하이라이트 (Highlight)
마우스 드래그나 도형으로 특정 영역을 표시합니다. AI는 이 표시 영역을 입력 이미지의 중심 정보로 인식합니다. 즉, 하이라이트는 “이 부분이 현재 작업의 초점이다”라는 명시적 좌표 정보 역할을 합니다.
② 지시 언어 (Positional Language)
AI는 공간 좌표 체계가 없으므로 “좌측 상단”, “중앙 오른쪽”, “하단 루버 부분”처럼
위치를 언어적으로 표현해야 합니다. 이런 문장은 AI가 픽셀 데이터를 해석할 때 ‘상대적 위치’를 추론하는 보조 데이터가 됩니다.
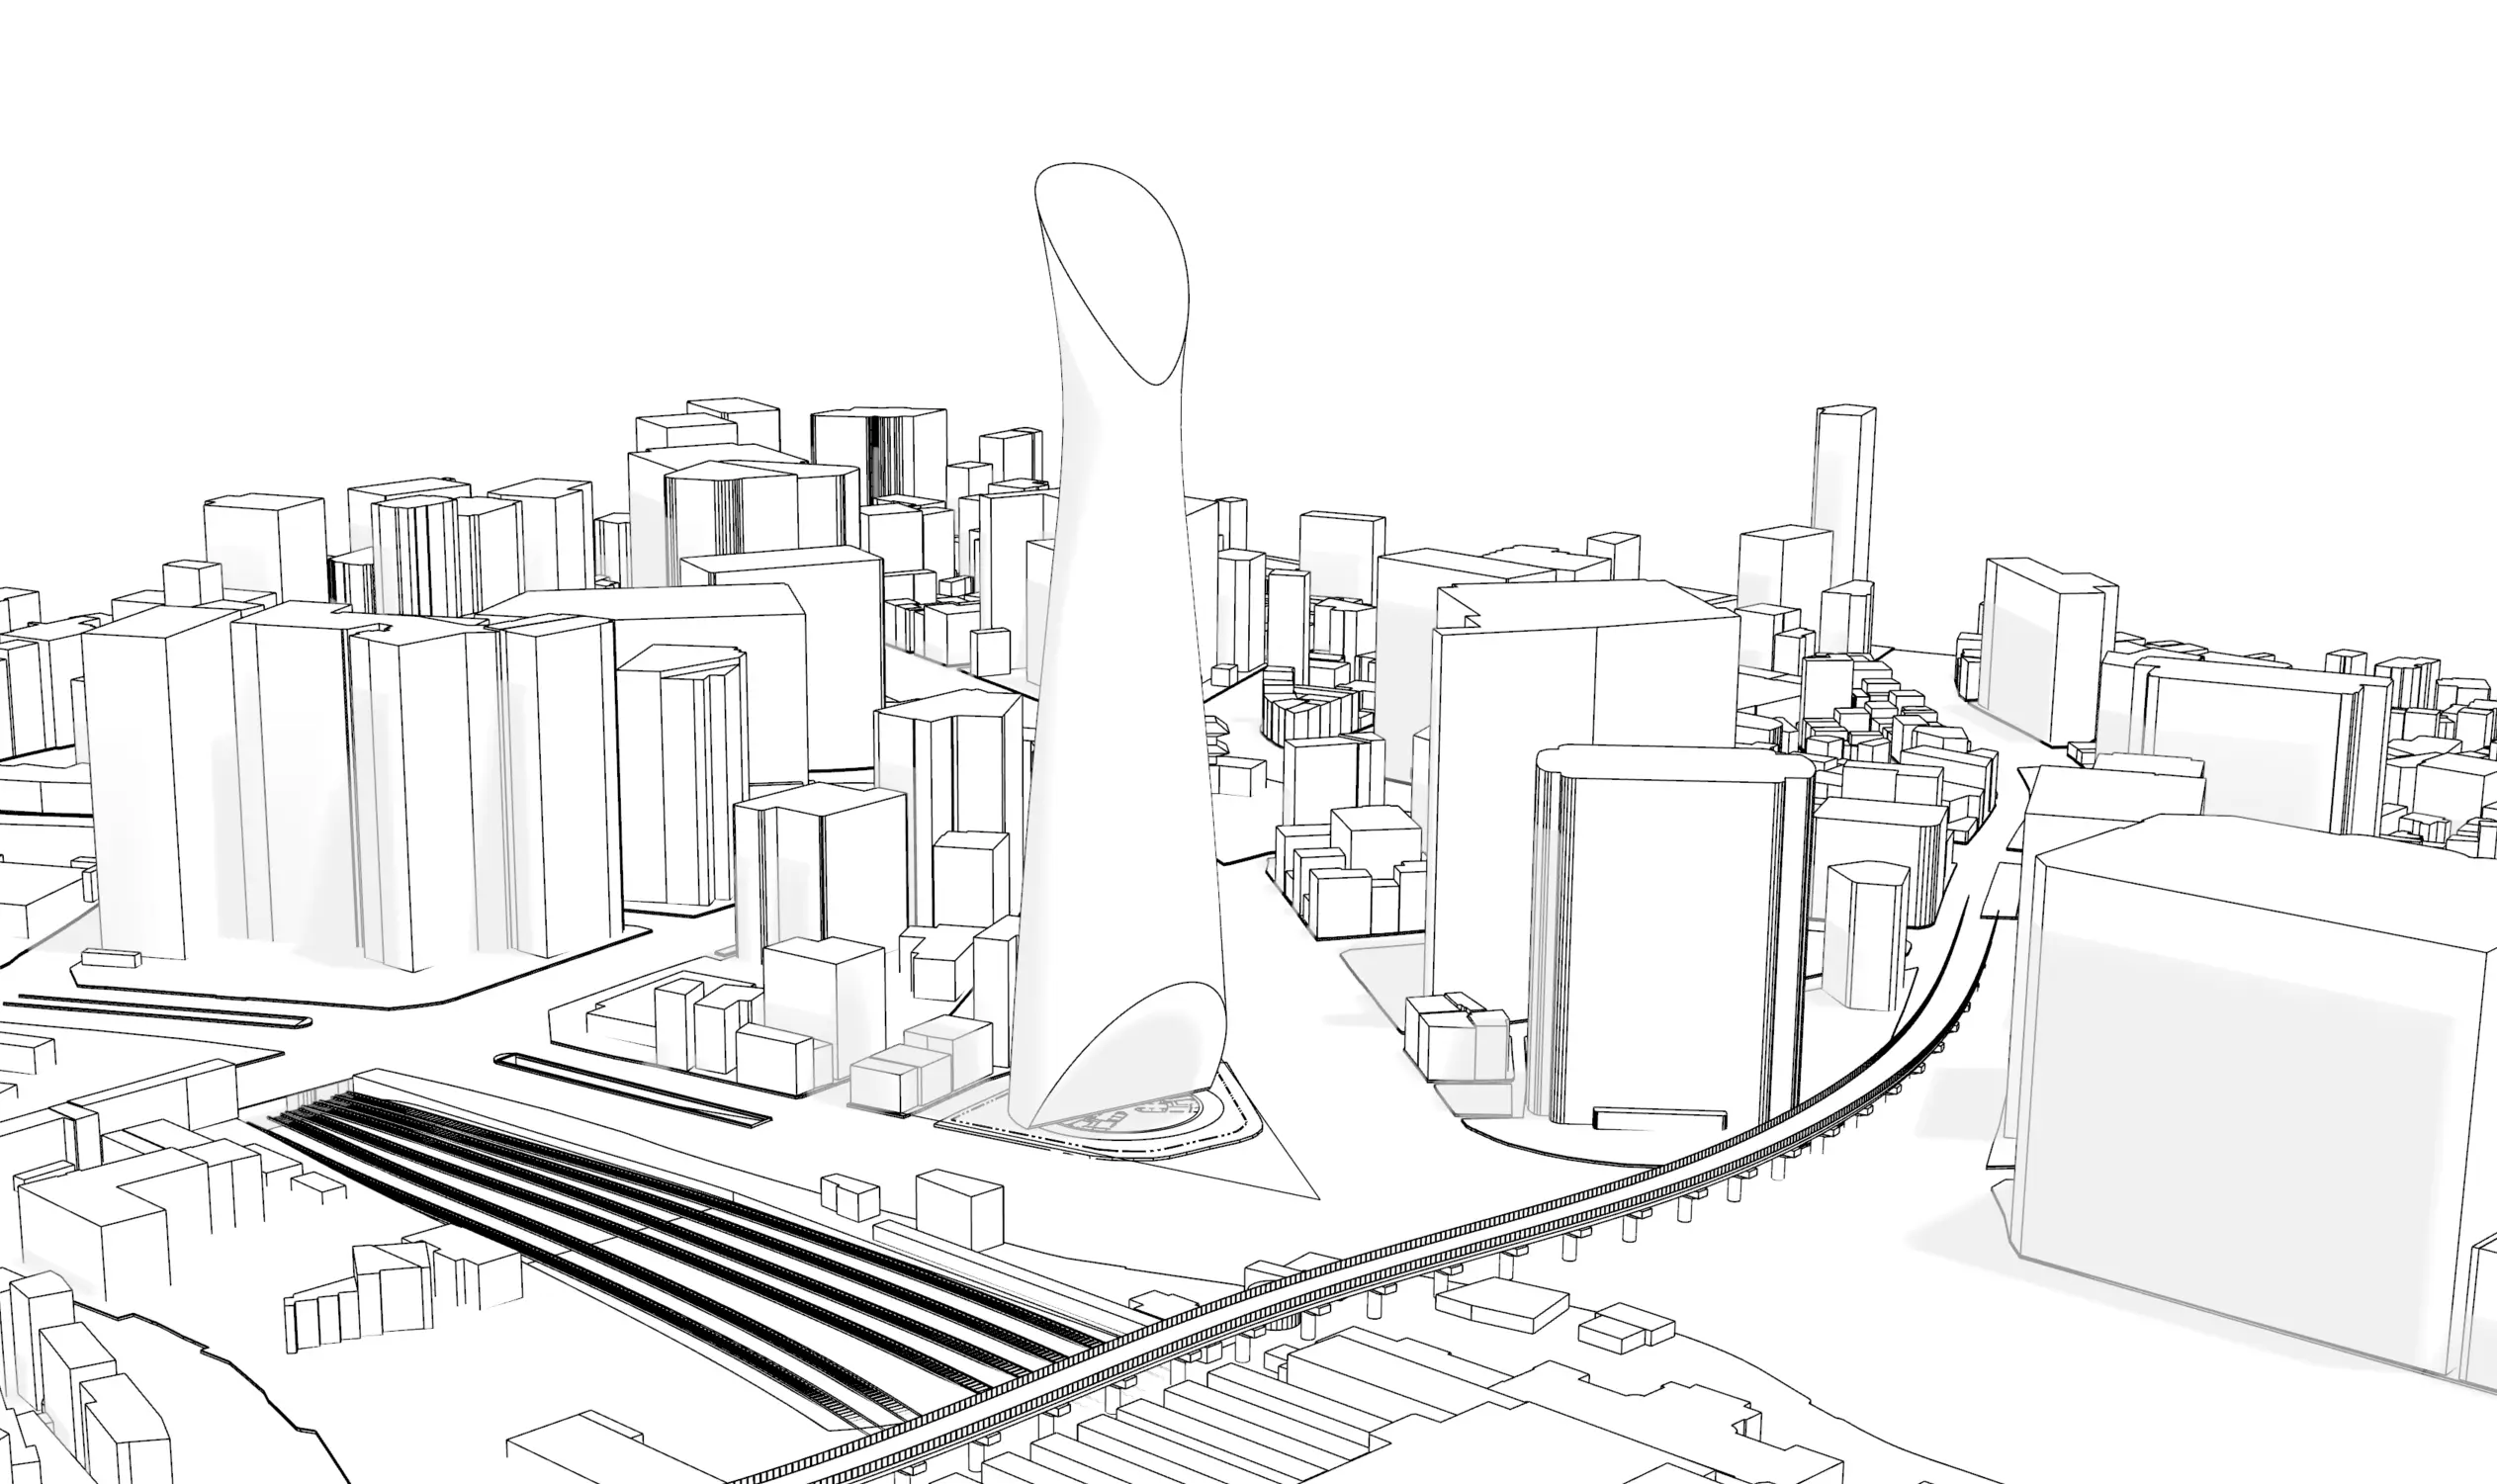
③ 프레임 리셋 (Frame Reset) (3D일 경우)
화면을 회전하거나 확대할 때 “이건 같은 모델의 다른 각도예요.”처럼 맥락을 다시 선언합니다. 이 입력은 AI가 각 프레임을 별개 이미지로 착각하지 않게 하고, 시점 이동의 연속성을 보장합니다.
④ 시점 요약 (View Summary)
일정 단위의 작업 후 “지금까지는 평면을 다듬었고, 이제 입면을 수정할 거예요.”처럼
현재까지의 맥락을 요약합니다. AI는 순간적 입력 중심으로 동작하므로, 이 요약은 대화의 시퀀스를 재정렬하는 역할을 합니다.
Part 3. 화면공유 + 보이스챗 이용하기
현재 크게 2가지 AI를 활용한 방법이 있습니다.
Geminai API
Geminai & GPT mobile
1. Geminai API
<순서도>
Google에 Get started with Live API 검색 > API 사용해보기 > Share Screen
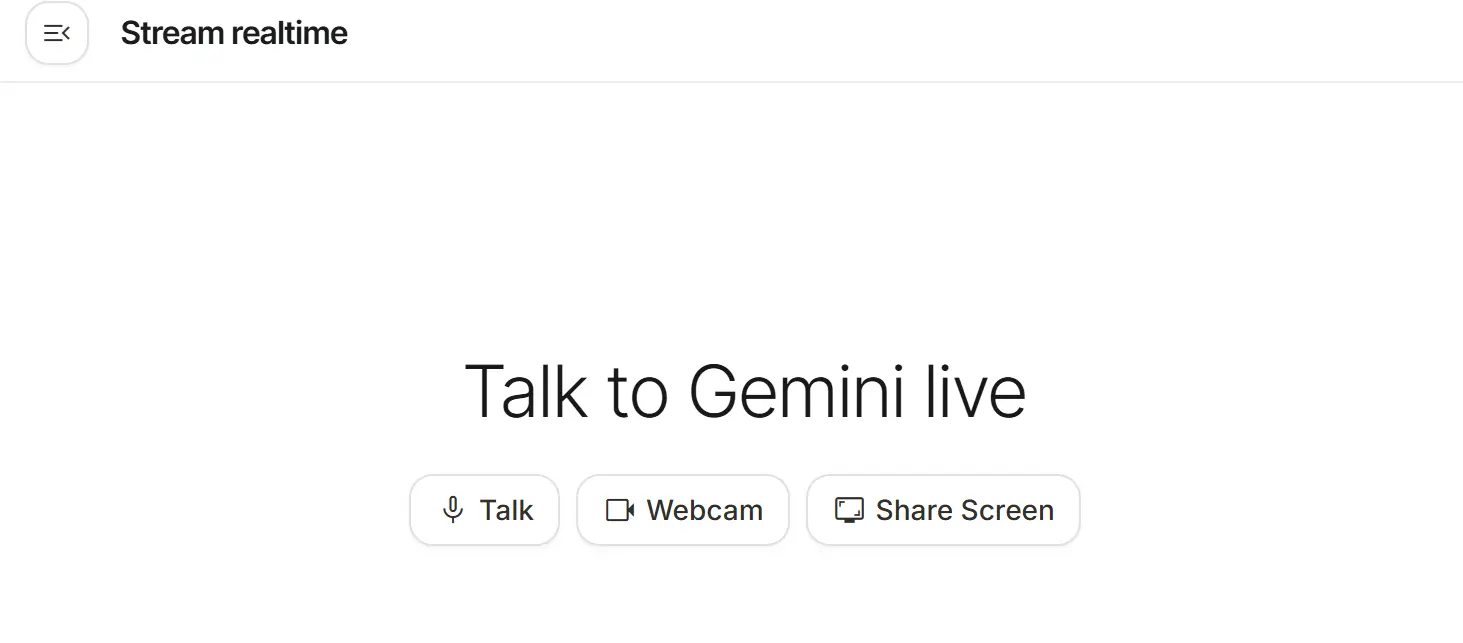
현재 Gemini Live 기능을 구동하는 핵심 기술인 Live API 및 지원 모델들은 정식 출시 전 단계인 프리뷰(Preview) 상태로 제공되고 있습니다.
사용 권고의 관점: Gemini Live는 실시간 대화 및 멀티모달 상호작용 측면에서 매우 혁신적이며 유용한 기능입니다. 따라서 기능을 사용해 보는 것은 충분히 가치가 있습니다.
사용 시 유의점: 다만, 현재 프리뷰 상태이기 때문에 간헐적인 기능 변경, 예기치 않은 오류 또는 일시적인 서비스 중단 가능성이 있음을 인지하고 사용해야 합니다.
실제로 화면 공유가 멈출 경우, Resume을 눌러 화면 공유를 재시작해야 합니다.
2. Mobile Application 활용
<순서도>
모바일 어플 실행 > 보이스 기능 실행 > 카메라 실행
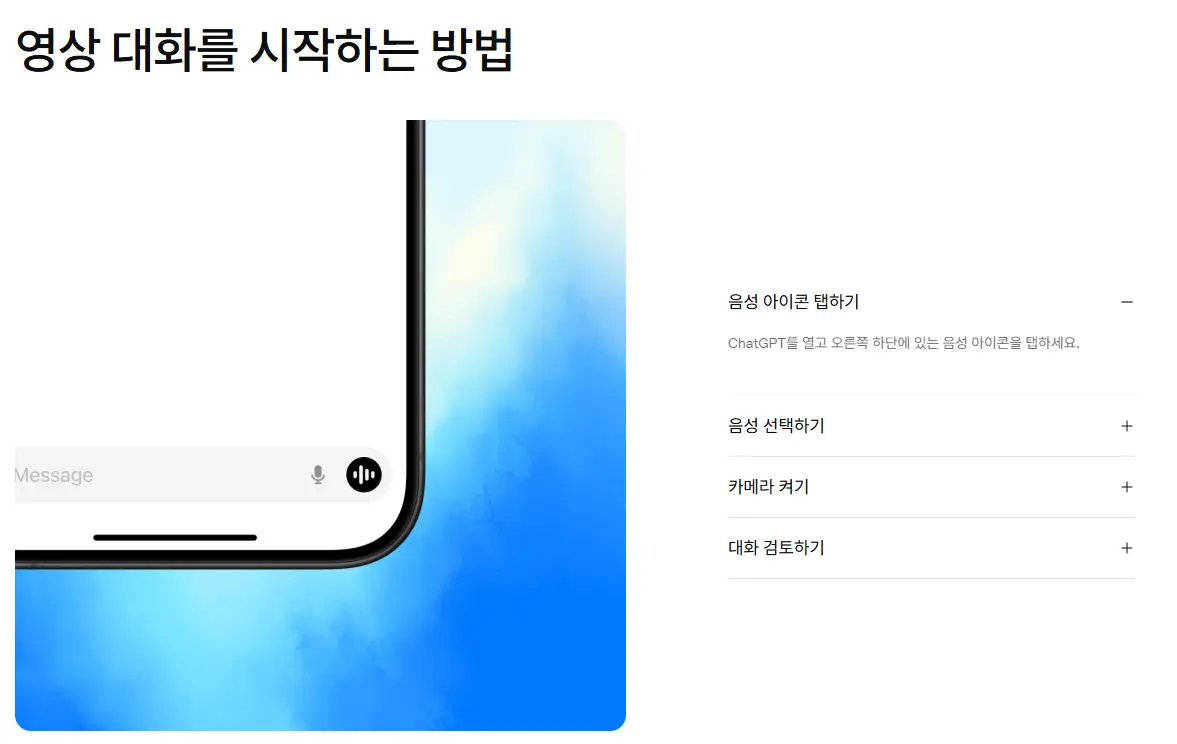
휴대폰 기능을 활용해 실제 도면이나 모니터를 보여주면서 피드백 받을 수 있습니다. 다만, 손으로 들고 있어야하기 때문에 번거로운 단점이 있으며, 구독에 따라 시간 제한이 있는 단점이 있습니다.
한계
현재의 AI는 **대규모 언어모델(LLM)**에서 출발해, 그 위에 **시각 정보를 해석하는 기능(Vision Encoder)**을 덧붙이며 발전했습니다.
따라서 우리가 기대하는 ‘시각 정보와 청각 정보의 완전한 동시 이해’는 아직 구현되지 않았지만, 점진적으로 개선되고 있습니다.
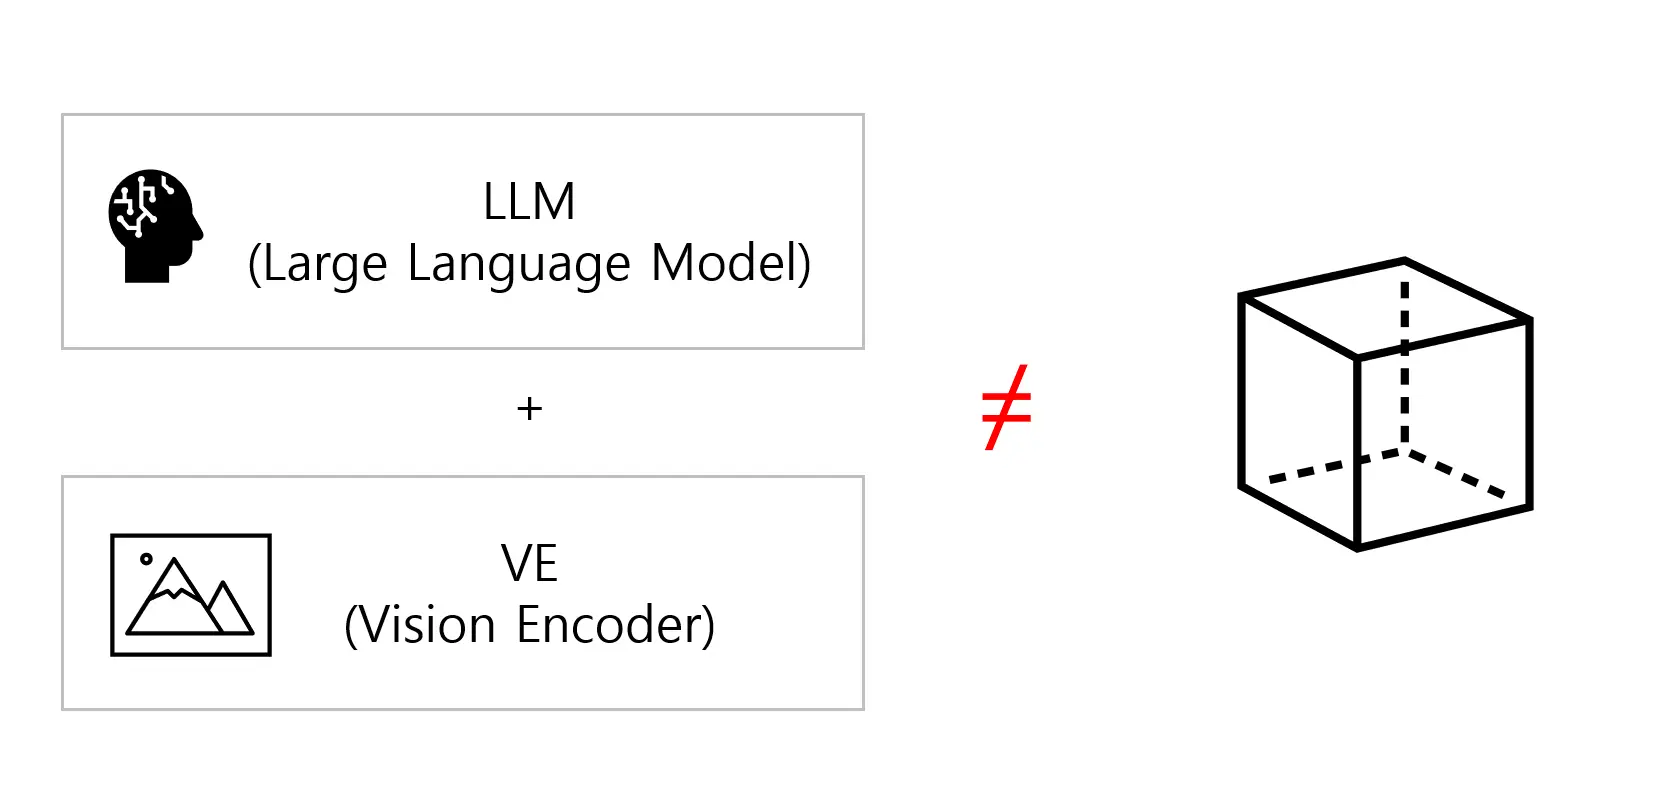
가장 큰 기술적 한계는 3차원 좌표계 인식 부재입니다. AI는 이미지를 픽셀 단위의 2차원 데이터로 처리하기 때문에, 깊이·거리·방향 같은 공간 좌표를 계산하지 못합니다.
이로 인해 건축 분야에서는 형태를 ‘이해’하기보다는 ‘묘사’하는 수준에 머무르게 됩니다.
즉, AI는 시각적 의미를 분석할 수는 있지만, 그 의미가 공간상 어디에서 발생했는지를 인식하지 못합니다. 이 점이 현재 건축 설계 환경에서 AI의 실시간 분석과 피드백 활용을 어렵게 만드는 주요 요인입니다. 그럼에도 불구하고, 우리는 이 기술을 멈추지 않고 사용해야 합니다. 이러한 반복적 사용이 곧 ‘데이터 축적을 통한 진화’의 기반이 되기 때문입니다.
전망
향후 전망은 분명합니다. 현재 연구의 초점은 “3D 엔진의 공간 계산 능력”과 “언어모델의 추론 능력”의 결합에 있습니다. DeepMind와 OpenAI를 비롯한 여러 연구 기관이 이 두 구조를 통합하려는 시도를 진행 중입니다. 이는 곧, AI가 단순히 결과를 해석하는 존재에서 공간을 직접 이해하고 조작할 수 있는 존재로 나아감을 의미합니다.
그 미래의 모습은, 마치 영화 아이언맨에서 토니 스타크가 자비스와 대화하며 실시간으로 프로젝트를 진행하는 장면을 그려볼 수 있습니다.
화면 속 텍스트를 넘어서, 우리 실재하는 공간 자체가 대화의 무대가 되는 시대입니다. 이제 남은 질문은 하나입니다. 그러한 환경 속에서 우리는 어떤 기준과 태도로 이 기술을 건축의 언어로 번역할 것인지는 우리의 몫으로 남아 있습니다.